総務省の「令和7年版 情報通信白書」によると、業務で生成AIを利用している日本企業は55.2%にのぼる。ChatGPTや社内LLMの導入は、もはや一部の企業だけの取り組みではない。
しかし、自社データを生成AIに活用しようとした段階で、プロジェクトが止まるケースは少なくない。その背景にあるのが、個人情報や機密情報取り扱いに対する懸念だ。
コールセンターの応対記録や営業日報、議事録、診療記録などの非構造化データには、個人情報がさまざまな形で含まれている。どこに何が記載されているかを一律に把握するのは難しい。人手で取り除こうとすれば、膨大な工数がかかる。
「データはあるのに、使えない」という壁は、なぜ生まれるのか。安全性を確保しながら、データの有用性を残すには何が必要なのか。
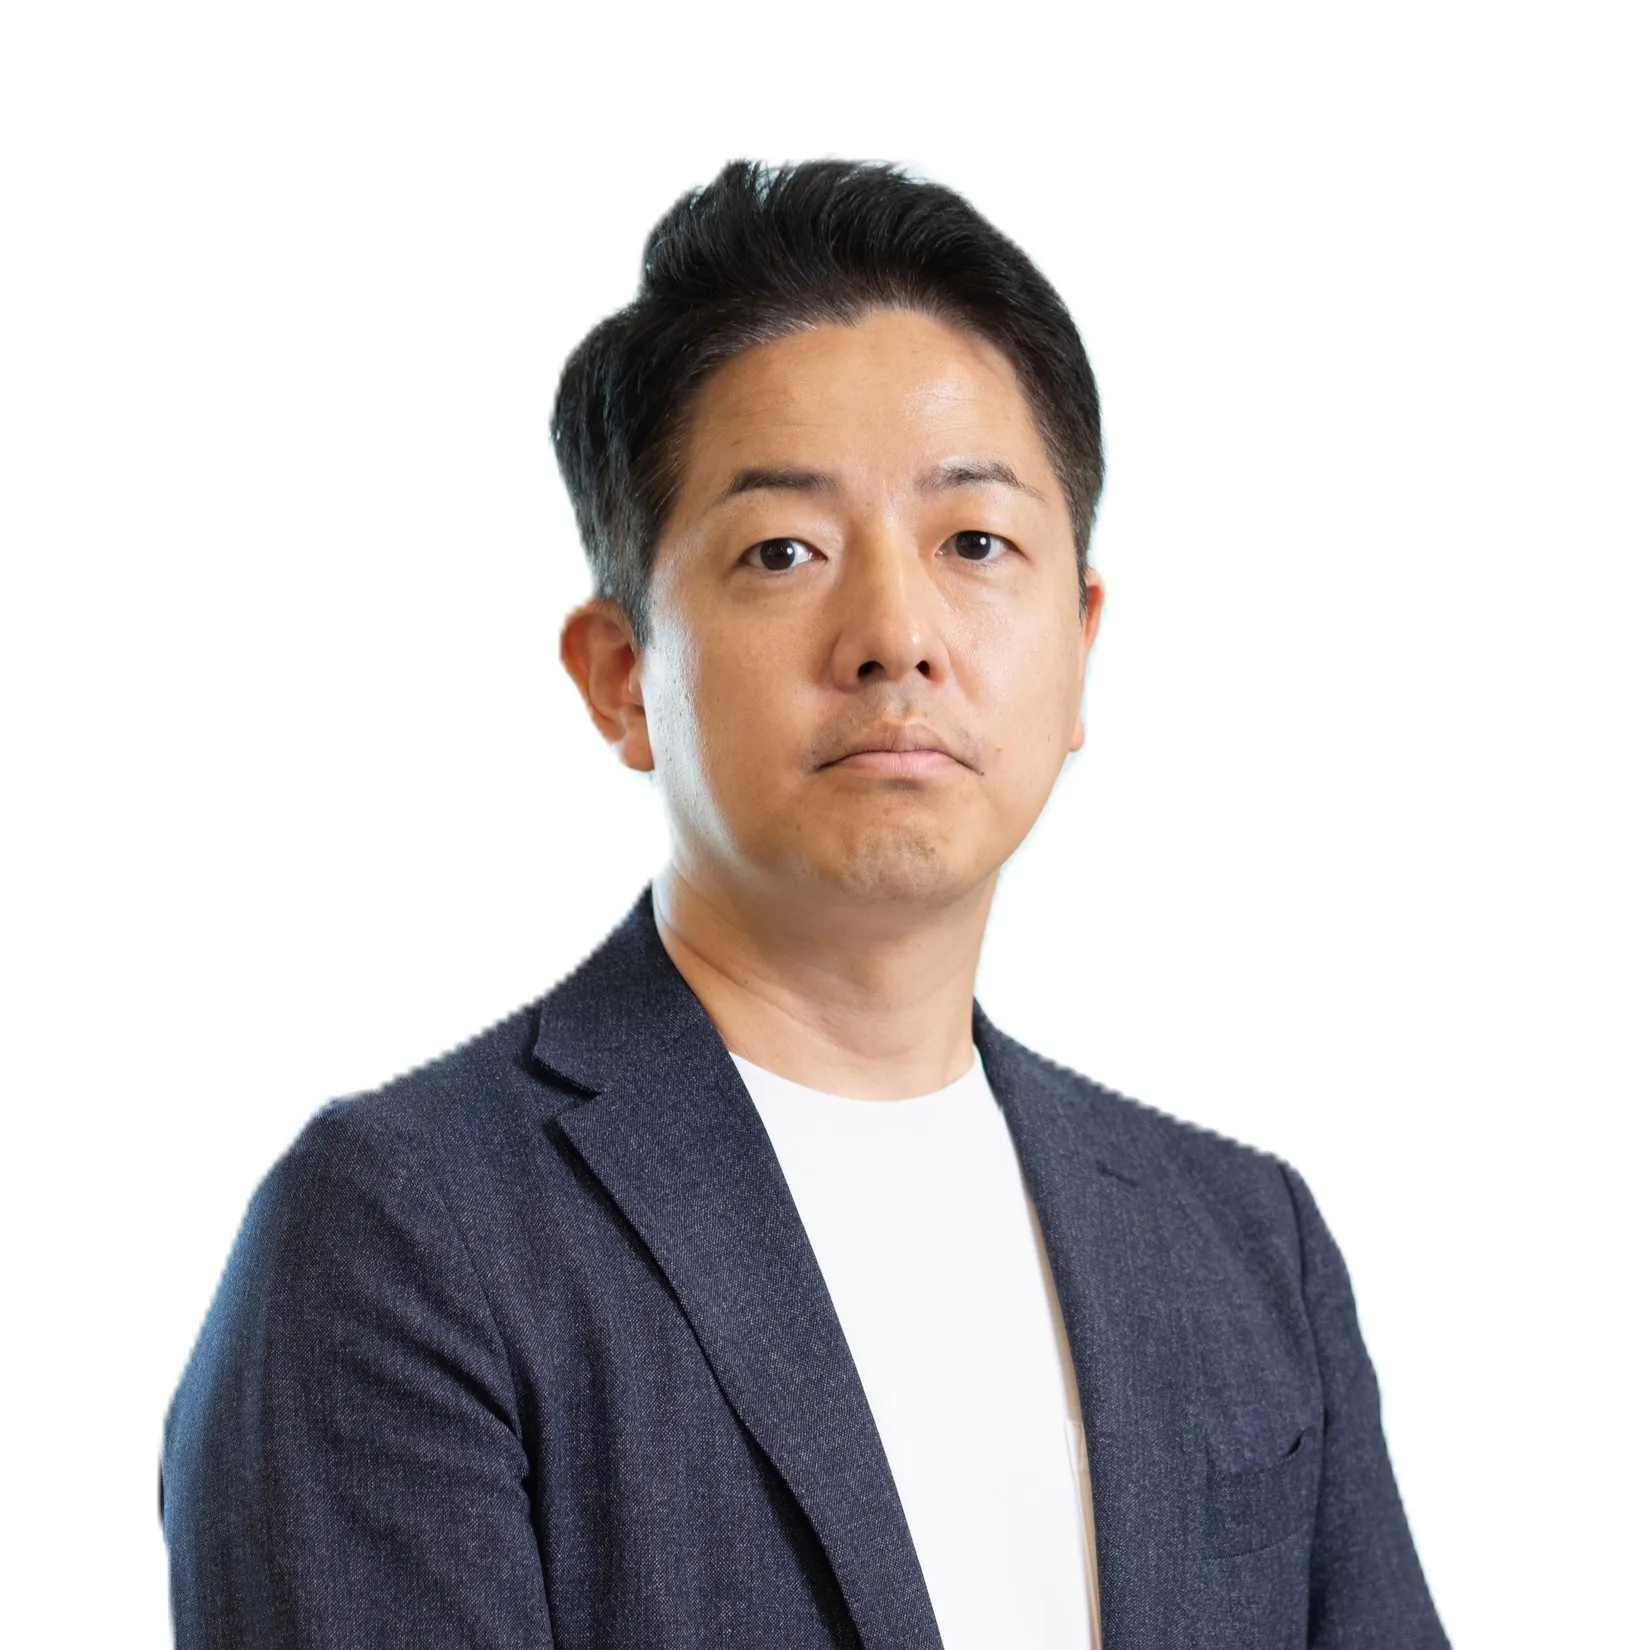
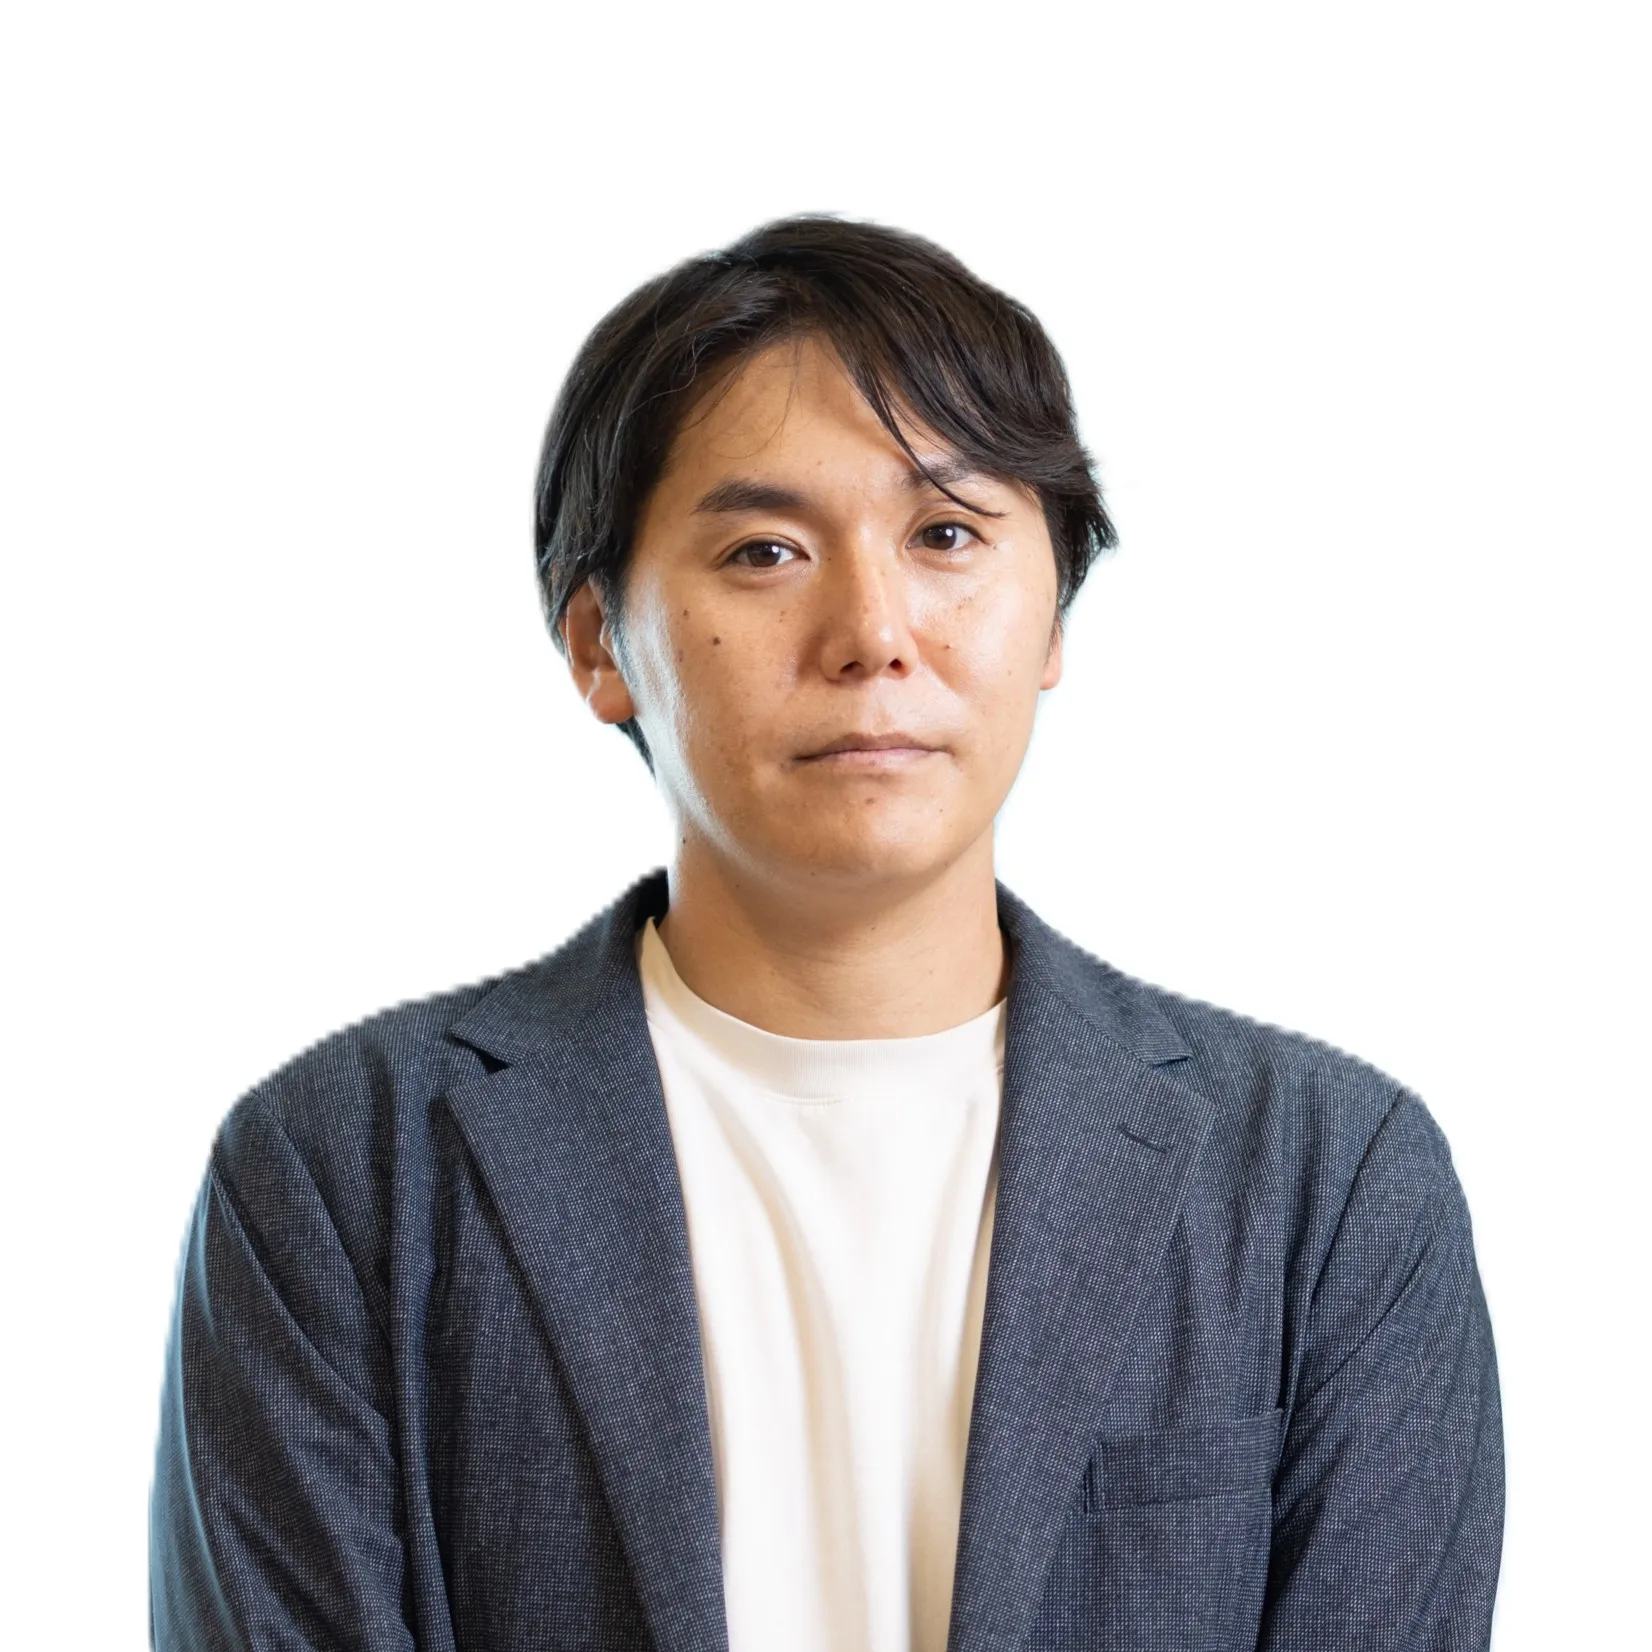
本稿では、「Insight Masking」を開発する株式会社インサイトテクノロジー プロダクトソリューション本部 本部長 中川 一郎 氏と、同製品を取り扱う丸紅I-DIGIOグループ デジタルソリューションセグメント デジタルプラットフォーム事業本部 エンタープライズソリューション営業部 部長 星野 智紀に話を聞いた。
個人情報を含むデータの活用に、こんなお悩みはありませんか?
- 顧客データを分析・活用したいが、個人情報の取り扱いに不安がある
- 氏名や住所のマスキング・匿名化を手作業で行っており、負担も漏れのリスクも大きい
- 法改正も見据えて、匿名加工・マスキングを継続できる仕組みを整えたい
上記のようなお困りごとがありましたら、データマスキングソフトウェア「Insight Masking」をご検討ください。日本語に最適化されたLLMを搭載し、個人情報や機微情報を自動的に検出してマスキングします。フリーテキスト中の個人情報抽出に加え、データベースのマスキングではテーブル間の参照整合性を保ったまま加工することも可能です。
\AIで個人情報を自動検出・マスキング/
Insight Maskingの資料ダウンロードはこちら生成AI活用を止めているのは、技術ではなくデータ
――生成AIの導入が進む一方、社内データの活用段階で止まるケースも多いと伺います。その背景をお教えください。
中川氏 AI活用を推進されている多くの企業では、データを利活用したい側と、セキュリティ・プライバシーを守る側とが社内で分断しているという構図が起きています。守る側はリスク・コンプライアンス部門や情報システム部門、法務部門。いわば、企業のデータ防衛の砦ですね。一方、経営推進や営業推進の部門は、一日も早くAIにデータを渡し活用したい。両者の考えが正面からぶつかっています。
企業の前に立ちはだかる壁は、大きく三つあります。
一つ目は、情報漏えいへの不安です。個人情報がAIの学習に使われるにとどまらず、プロンプトインジェクションなどから外部へ流出するのではないか、といった懸念ですね。
二つ目は、守る側に根強い「オール・オア・ナッシング」の発想です。一件も漏らさないことを絶対条件にすると、全社的な活用はなかなか広がりません。最近は、一定のリスク許容度を定めたうえで活用する方向へ変わりつつありますが、そうすると今度はデータの加工に膨大な工数がかかります。
三つ目は、データの安全性と有用性の両立です。データをすべて塗りつぶしてしまえば、AIも人も文脈を理解できません。最低限の意味を保ちながら、安全に使える状態をつくる必要があります。ここをどう成立させるかが、多くのお客様に共通する課題だと思います。
星野 現場では、データがオンプレミスやクラウドなど複数の環境に分散しており、統合の段階からコストが発生します。必要なデータと不要なデータの仕分けが十分に行われていないケースも少なくありません。
さらに、日本企業では「データの管理者」という役割が明確に定義されていない場合もあります。そのため、体制づくりから着手しなければならず、取り組みたいにもかかわらず一歩を踏み出せない企業が多いのが実情だと思われます。
自由記述のなかに、個人情報は静かに紛れ込む
――非構造化データには、どのような情報が潜んでいるのでしょうか。また、非構造化データをそのまま用いるリスクはどんなものが挙げられますか?
中川氏 コールセンターのコールログ、営業日報や議事録、電子カルテの記述、自治体の住民対応記録。これらはすべて自由記述です。
だからこそ、予期せぬ機微な個人情報や、企業内のビジネス機密が自然と紛れ込むことがあります。そんな情報を含んだ生のデータをそのまま利用すれば、法務面でも経営面でも重大なリスクになり得ます。
リスクは、大きく三つに整理できます。
一つ目は、外部への情報送信です。主要なクラウドAIサービスでは、入力データをモデルの学習に使用しない「オプトアウト」と呼ばれる覚書も用意されています。しかし、最新のモデルを使用する場合など、あるケースではモデルの推論が海外拠点で実行されるなどの不安が残ります。また、システムの設計が不十分な場合、プロンプトインジェクションなどをきっかけに情報が流出する可能性は残ります。本来は社内の一部しか閲覧できない情報が、外部へ出てしまうかもしれません。
二つ目は、社内での横断的な情報取得です。生のデータを社内LLMやRAGに取り込むと、一般社員がプロンプトを通じて機密情報にアクセスできる可能性があります。社外へ流出していなくても、権限のない社員が閲覧すれば情報漏えいにあたる可能性が残ります。
三つ目は、法令への対応です。国内の個人情報保護法はもちろん、海外に拠点やユーザーを持つ企業では、GDPRなどへの対応も必要になります。
また、見落とされやすいのが、クラウド事業者のオプトアウトにおける責任共有モデルです。AI環境を構築し、権限を設定するのはお客様です。権限設計の不備によって情報が漏れた場合、お客様側の責任になることがあります。クラウドを利用すれば、すべてをベンダーが守ってくれるというわけではないのです。
星野 単体では特定できない情報であっても、組み合わせることで個人を特定できてしまう点にも注意が必要です。
たとえば、地域・年齢・病名などの情報が重なることで、特定の一人に絞り込まれてしまう可能性があります。
また、コールセンターの応対記録には、顧客に対するオペレーターの主観的な評価が記載されていることも少なくありません。
このようなデータを十分な加工や匿名化を行わずに利用すること自体が、リスクを生む要因になると考えるべきでしょう。
「データはあるのに使えない」現場のジレンマ
――実際には、どのようなご相談が寄せられていますか。
星野 「SFAに蓄積された商談メモをAIで活用したいが、顧客名や未公開情報が含まれているため、そのまま入力できない」といった相談が寄せられます。
また、社員が自社システムの設計情報を外部の生成AIに入力し、意見を求めていたという事例もあります。本人に悪意はなくても、結果として機密情報を外部へ提供したことになってしまいます。このように、AIに入力してよい情報の線引きが曖昧なまま、利用だけが先行している企業も少なくありません。
医療機関からは、膨大な診療データを研究機関へ提供して活用したいものの、個人情報を含むため十分に活用できない、という相談があります。
自治体も同様です。生活保護、子育て、介護などのケース記録が蓄積されているものの、個人情報が多く含まれているため、外部への提供や二次利用が難しいという課題を抱えています。
このように、活用したいデータはあるにもかかわらず、個人情報や機密情報が障壁となり、十分に活用できていないという相談が、業種を問わず寄せられています。
非構造化と日本語が重なる、三つの難所
――構造化データと比べて、非構造化データの匿名化はなぜ難しいのでしょうか。
中川氏 構造化データは、データベースの列ごとに項目が定義されています。そのため、たとえば「氏名」の列を対象に処理できます。
一方、非構造化データには、大きく三つの難しさがあります。
一つ目は、スキーマが定まっていないことです。文章のどこに個人情報が現れるか分かりません。一通のメールに一つも含まれていない場合もあれば、大量に含まれている場合もあります。
二つ目は、文字種の混在です。英語は一般的に単語がスペースで区切られています。一方、日本語の文章には、漢字・ひらがな・カタカナ・アルファベット・数字などが混在します。単語の境界も明示されません。そのため、ルールベースだけで情報を正確に検出するには限界があります。
三つ目は、同じ表記が異なる意味で使われることです。よくお客様にお伝えするのが、「千葉さんが千葉市にある千葉製作所を訪問した」という例です。
同じ「千葉」という表記でも、最初は人名、次は地名、最後は会社名です。それぞれのカテゴリーまで認識して検出することは、ルールベースだけでは非常に困難です。
単に情報を隠すのではなく、意味を理解したうえで保護する。安全性と有用性を両立しようとすると、こうした難しさが生じます。
手作業と単純置換では、工数も品質も持たない
――現状は手作業や単純な文字置換で対応している企業も多いと思います。そこにはどのような限界がありますか。
星野 まず問題となるのが工数です。人手と時間が膨大にかかるうえ、目視で確認する以上、ミスを完全に防ぐことはできません。
さらに、チェックの精度は担当者の経験やスキルに大きく左右されます。作業が属人化しやすく、担当者によって品質にばらつきが生じてしまう点も大きな課題です。
中川氏 前提として、マスキング作業そのものが利益を生み出すわけではありません。できる限り効率化すべき工程です。
ここは、この二年で大きく変わった点で、以前は「目視で100%確認する」が前提でした。一方、現在は、完全な検出が難しいことを踏まえ、残るリスクを運用でどう補うかが議論されています。こうした現実的な考え方を持つお客様のほうが、うまく取り組みを進めています。
どこまで許容するかを決められるのは、ベンダーでもコンサルでもなく、お客様自身です。そもそもマスキングはAI活用の前処理ですから、ここに工数がかかっては本末転倒です。
たとえば、指標の一例としては、ROIから逆算して「一件あたり何秒以内」という水準まで落とし込めていれば、私たちも製品をその目標値に向けてチューニングできます。
守りつつ、使える形で残す
――「個人を特定できる情報は保護しつつ、分析や開発に必要な特徴は残す」という考え方について教えてください。
中川氏 分析に使う場合も、LLMに学習させる場合も、年齢や地域などの情報を完全に消してしまえば、データの価値が失われます。エリアや季節性、単価などは、分析に欠かせない軸です。
そこで、たとえば32歳、45歳というデータを、30代、40代に丸める。それでも分析軸としては十分に機能しますし、一定の保護はされています。住所であれば、丁目番地以下だけを隠す。渋谷区まで残すのか、都道府県までにするのか。データを柔らかくする、というイメージですね。最終的に何に使うのか、ゴールから逆算して、どこを守り、どこをぼかすかを決めることが重要です。
構造化データにおいては、文字種や文字長、複数テーブル間の参照整合性、IDのユニーク性も同じ理由で重要です。マスキングした結果テーブル構造が変わったり、アプリケーションが発行するSQLが通らなくなったりしては、テストデータとして意味がありません。
アクセス権限管理やDLPとは、役割が違う
――既存のアクセス権限管理やDLPとは、どう違うのでしょうか。
星野 アクセス権限管理やDLPは、基本的に「見せる人には見せ、見せない人には見せない」という制御です。しかし、閲覧できない人は、そのデータを活用できません。
一方、データを見せる前に安全な形へ変換すれば、より多くの人が分析などに利用できます。データの活用範囲を広げるという点で、事前のマスキングにしかできないことがあると思います。
中川氏 アクセス権限管理やDLPとマスキングは、対立するものではありません。また、それぞれ役割が異なり、共存するものです。アクセス権限管理は閲覧者を制御し、DLPはデータの持ち出しを検知・遮断します。いずれもデータの取り扱いを制御する仕組みであり、データそのものを加工するわけではありません。
そして、アクセス権限によって閲覧者を制御し、DLPで出口を絞る。さらに、データパイプラインへマスキング処理を組み込む。
この組み合わせによって、堅牢なAIデータ基盤を構築できます。
マスキング技術「Insight Masking」が実現すること
――「Insight Masking」の概要と特徴をお教えください。
中川氏 Insight Maskingは、お客様のありとあらゆるデータに対して、自社開発の個人情報検知に特化したAIでマスキングを施すソリューションです。SaaS、IaaS、オンプレミスのいずれの環境でも動作します。
その特徴は、日本語への検出精度、処理速度、対応データ形式の幅広さ、そして専業ベンダーならではの伴走です。データベースやCSV、Parquet、Officeファイル、PDF、PDFのなかの画像まで対応し、実用レベルで確実にお使いいただけるところまで徹底的にアジャストします。
また、別の視点では、一つのプラットフォーム、一つのライセンスで複数の用途に使える点は、かなりユニークだと考えています。テストデータのマスキングは情報システム部門、AI用データの準備はDX推進部門、情報公開請求への墨消し対応は自治体の窓口担当者と、使う人も部門もまったく違う用途を一つの基盤でカバーできます。
それぞれの領域に専業の製品ベンダー様はいらっしゃいますが、複合的に使えるのは私たちだけだと考えています。
――文脈を保ったまま個人情報を検出できるのは、どのような仕組みによるものでしょうか。
中川氏 固有表現抽出は、生成AIが広く普及する以前から存在する技術です。私たちも2020年頃から研究開発を進めてきました。生成AIブームに合わせて開発を始めたわけではありません。
文脈理解の基礎となるモデルは、文章を前後両方向から読み取ります。これにより、先ほどの「千葉」が人名・地名・会社名のどれにあたるのかを判別しやすくなります。
さらに、従来のルールベースによる検出も組み合わせています。マイナンバーやクレジットカード番号には、番号が正しいかを確認する仕組みがあります。似た桁数の数字が並んでいても、アルゴリズムによって判別できます。
導入後は、辞書や正規表現によるカスタマイズも可能です。決まった取引先の一覧や、自社固有の製品番号などは、辞書へ登録したほうが効率よく検出できます。
ルールの優先順位は、ドラッグ&ドロップで変更できます。自社独自のルールを、AIによる判定より優先することも可能です。
ただし、精度については正直にお伝えしています。AIによる検出の課題は、過剰検出と検出漏れの二つです。100%完全な検出は存在しませんし、お客様のビジネスゴールに伴走しながら、目標値や運用に落とし込んでいます。
重要なのは、運用のなかで精度とどう向き合うかです。製品だけではカバーできない部分を運用で補い、プロジェクト全体でROIが見込めるかを判断する。それが最も健全な考え方だと思います。
――処理性能についてはいかがでしょうか。
中川氏 公表している数値では、CSVのマスキング処理で毎秒130万レコードを記録しています。他社製品との比較では150倍以上の処理性能となり、1日かかっていた作業が10分に短縮された例もあります。
現場にとって象徴的なのは、日次バッチでしか処理できなかった業務を、即時に実行できる可能性が生まれることです。
たとえば、コールセンターでオペレーターの会話をリアルタイムにテキスト化し、そのデータをマスキングしてナレッジ検索にかけ、応答候補を提示する。こうした生成AIエージェントの実証実験にも成功しています。音声認識、マスキング、検索のすべてを高速に処理できなければ、このようなリアルタイムでの運用は成立しません。
システムテストでも効果は明確です。結合テストは何度も回しますから、数か月かかっていた検証期間が大幅に短くなる。処理が150分の1で終われば、クラウドリソースの稼働時間も150分の1。インフラコストにも直結します。
――協業によって、丸紅I-DIGIOグループとしてはどのような価値が生まれているのでしょうか。
星野 丸紅I-DIGIOグループでは、これまでマスキング製品を取り扱ってきませんでしたが、当社ソリューションのラインアップの中で空いていた領域に、Insight Maskingが非常にうまくフィットした、というのが率直なところです。
私たちは長年にわたり、サーバーやストレージといったインフラ領域を手がけ、お客様のデータの「置き場所」を提供してきた実績があります。AIの時代となり、「GPUサーバーを立ててAI基盤を構築しましょう」というご相談をいただく場面が増えるなかで、「そのデータはマスキングしないと安全に使えません」という提案をセットで行えるようになりました。
さらに、自社のAI-OCR製品やコンタクトセンター関連製品との組み合わせも可能です。
このように、単一の製品ではなく、複数のソリューションを組み合わせた形でご提供できる点こそが、丸紅I-DIGIOグループとしての価値であると考えています。
活用シーンは「業種」ではなく「個人情報の量」で決まる
――具体的には、どのような場面で活用されていますか。
星野 一つ目は、テストデータの生成です。開発部門では、検証環境で確認したものを本番環境に適用しますが、単純なダミーデータでは十分な検証になりません。本番とまったく同じデータ形式であることが重要です。そこでマスキングデータを用いることで、本番と同様の環境で検証でき、品質向上とリスク低減の両立が可能になります。
二つ目は、公共分野における第三者開示時の個人情報の墨消しです。現在も、第三者に開示する資料の個人情報を職員が手作業で黒塗りしている現場は少なくありませんが、この作業には膨大な時間がかかります。さらに、対象範囲が多岐にわたる場合や、膨大な量の墨消しが必要な場合には、人為的な見落としや誤りが生じるリスクもあります。そこで、AIを活用したマスキングツールを導入することで、墨消し作業時間の大幅な短縮と人為的ミスの削減による情報漏えいリスクの低減、さらには作業コストの削減が期待できます。
三つ目は、分析基盤や生成AI利用のための前処理です。ローカルLLMやデータレイクを構築する際、個人情報を含んだままのデータを取り込むと、そのまま個人情報を学習してしまい、情報漏えいにつながるおそれがあります。そのため、取り込み前に個人情報を適切にマスキングしておくことが不可欠です。
個人情報の取り扱いが多いのは医療機関や公共分野ですが、一般企業においても、社員情報や名刺情報、議事録に含まれる顧客の個人情報などが存在します。マスキングの必要性は、業種や業界そのものではなく、「どれだけ個人情報を扱っているか」によって決まると考えています。
中川氏 最近増えているのが、マルチモーダルなデータへの対応です。人が行っていた一次審査を、AIエージェントへ任せたいという相談が増えています。
しかし、AIへ渡すデータは、画像やPDFなどの形式であることが少なくありません。テキストとして検索できないデータも多くあります。
たとえば、申込書類を撮影してアップロードする業務では、人が複数の証明書類を目視で確認しています。この業務をAIへ任せようとしても、画像を人が手作業でマスキングしていては本末転倒です。自動化で削減した工数を、マスキング作業に費やすことになります。
そこで、丸紅I-DIGIOグループのAI-OCRを使い、画像内の情報を検索可能な状態にします。そのうえで、必要な箇所をマスキングしてAIへ渡す構成が有効です。
BPOやコンタクトセンターを運営する企業へ、今後ぜひ一緒に提案していきたい領域です。
まずは「何のためにAIを使うのか」から
――実務では「どの項目を、どこまで匿名化すべきか」に悩む企業も多いと思います。
中川氏 個人情報保護法でいう仮名加工情報と匿名加工情報の違いは、主に利用目的そのものです。社内で使うのか外部に出すのかが、大きな分かれ目になります。
もう一つの観点が、直接識別子と間接識別子です。詳細な住所を出せば、それだけで個人が特定できます。一方、「45歳」という年齢だけでは特定できません。ところが「45歳、男性、渋谷区勤務」と重ねていくと、間接識別によって対象が一人に絞られていきます。
ですから、社内か外部か、どの業務でどんなゴールのためにデータを使うのかを先に決め、そこから逆算してマスキングの強度を決めるべきです。
――では、これから取り組む企業は、どのようなステップで検討を進めるべきでしょうか。
星野 まず重要なのは、目的を明確にすることです。「とりあえずAIを導入する」のではなく、AIで何を実現したいのか――たとえば、社内問い合わせを一元化して担当者の負荷を軽減したいのか、営業企画用の資料作成を効率化したいのか、といった具体的なゴールを定める必要があります。
目的が定まれば、必要となるデータの範囲が見え、その中にどのような個人情報や機密情報が含まれているかも把握できます。そのうえで初めて、データを外部に出せるのか、どの程度のマスキングが必要なのかを判断できます。
次のステップが、システム連携の設計です。オンプレミスのデータを利用するのか、クラウド上のデータを連携させるのかといった方針を決め、周辺システムを洗い出してマッピングします。その際、アクセス権限や認証なども含めて、全体として適切に制御できているかを確認することが欠かせません。
また、PoC(概念実証)は必ず実施すべきだと考えています。構想段階のイメージと、実際のAIの出力結果が食い違うことは十分にあり得ます。いきなり本番環境に展開するのではなく、まずはPoCで本当に目的が達成できるかを検証してから判断していただきたいと思います。
最後に一つお伝えしたいのは、「100%完璧なAI」は現実的には存在しないということです。人が適切に指示を出し、その結果を評価・補正しながらAIを活用していくことが前提になります。AIに任せきりにするのではなく、人とAIが役割を分担し共存していく――そのようなスタンスで取り組んでいただくことが重要だと考えています。
中川氏 目的を決めましょうという点は、まったく同じです。トップダウンで「とにかくAIを使いなさい」と降りてきて、いざ使おうとするとリスク・コンプライアンス部門から止められ、法務部門からもNGが出る。板挟みになっている担当者の方を、本当によくお見かけします。
そこで、立ち返っていただきたいのが、「それは何のために実装したいのか」です。審査業務を自動化したい。黒塗り作業に費やしていた何千、何万時間という残業をなくしたい。それがビジネスゴールなら、そのためにどんなAIが必要で、どんなデータが必要で、そのデータにどんなリスクがあるのか、と分解していけます。
そして、データのゴールから逆算したマスキング要件、リスクの許容度、運用体制。この掛け合わせで、ぜひ目標値を出していただきたいですね。たとえば、「いま一件あたり5分かかっているチェックを、15秒以内にしたい」といったような分かりやすい目標が良いと思います。
目標値を決められるのは、ユーザー企業様だけです。逆に言えば、そこさえ外さなければ、環境の構築からAIアプリケーションの実装まで、丸紅I-DIGIOグループと私たちでエンドツーエンドに伴走できます。
生成AIの活用が止まる理由は、技術の不足ではない。むしろ、安全に使える形にデータを整えるという工程が、そもそも設計に入っていないことにある。アクセス権限管理やDLPが「誰に見せるか」を制御する仕組みだとすれば、マスキングはデータそのものを安全にする仕組みだ。両者は競合しない。組み合わせることで初めて、社内データを本格的にAIへ渡せる状態が整う。
そこで、丸紅I-DIGIOグループではInsight Maskingのご提案から実演デモ、PoC、導入後の運用定着までを一貫して支援している。
「社内にデータはあるが、AIに渡してよいか判断できない」「マスキングの工数が現実的でない」といった課題に心当たりがあるなら、まずは自社のデータをどこまで安全にできるのか、試してみるところから始めてみてはいかがだろうか。
個人情報を含むデータの活用に、こんなお悩みはありませんか?
- 顧客データを分析・活用したいが、個人情報の取り扱いに不安がある
- 氏名や住所のマスキング・匿名化を手作業で行っており、負担も漏れのリスクも大きい
- 法改正も見据えて、匿名加工・マスキングを継続できる仕組みを整えたい
上記のようなお困りごとがありましたら、データマスキングソフトウェア「Insight Masking」をご検討ください。日本語に最適化されたLLMを搭載し、個人情報や機微情報を自動的に検出してマスキングします。フリーテキスト中の個人情報抽出に加え、データベースのマスキングではテーブル間の参照整合性を保ったまま加工することも可能です。
\AIで個人情報を自動検出・マスキング/
Insight Maskingの資料ダウンロードはこちら